Сегментация — одна из самых частых задач маркетинговых исследований. Компания хочет понять, из каких групп состоит её аудитория, чем эти группы отличаются и на какие из них направить усилия. Разделить клиентов по полу и возрасту несложно, но такие сегменты редко объясняют поведение: два сорокалетних горожанина с одинаковым доходом могут выбирать продукт по совершенно разным причинам.
Кластерный анализ позволяет найти группы, которые объединены не демографией, а сходством ответов — потребностей, установок, поведения. Алгоритм сам определяет, кто на кого похож, и собирает респондентов в кластеры так, чтобы внутри группы различия были минимальными, а между группами — максимальными.
Но статистика — только половина дела. Сегментация, которую нельзя объяснить менеджеру по продажам за две минуты, остаётся в отчёте. Поэтому разговор о кластерном анализе — это одновременно разговор о математике и о здравом смысле.
Чем кластеризация отличается от простого деления
При априорной сегментации аналитик заранее задаёт правило: «покупают чаще раза в неделю — активные, реже — пассивные». Это быстро и понятно, но границы произвольны, а учитывается только один-два признака.
Кластерный анализ — апостериорный подход: группы выделяются по многим переменным одновременно, и их число и состав определяются данными. Это позволяет обнаружить сегменты, о которых заранее никто не догадывался. Например, среди покупателей бытовой техники может выделиться группа, для которой главное — не цена и не бренд, а возможность быстро получить товар в день заказа. Общие подходы к сегментации подробно описаны в статье о сегментации потребителей, здесь сосредоточимся на технике.
Выбор переменных — главное решение
Кластеры будут отражать именно те признаки, которые вы подали на вход. Если включить в модель отношение к цене, кластеры разделятся по ценовой чувствительности; если включить стиль жизни — по стилю жизни. Поэтому выбор переменных определяется задачей.
| Задача бизнеса | Переменные для кластеризации | Переменные для описания |
|---|---|---|
| Разработка продуктовой линейки | Важность характеристик продукта, сценарии использования | Демография, бренды, каналы |
| Коммуникация и позиционирование | Ценности, установки, мотивы выбора | Медиапотребление, доход, регион |
| Работа с клиентской базой | Частота, сумма покупок, набор продуктов | Удовлетворённость, канал обслуживания |
Важный принцип: переменные, по которым строятся кластеры, и переменные, которыми эти кластеры потом описываются, должны быть разными. Демография обычно идёт во вторую группу — она помогает найти сегмент и обратиться к нему, но не объясняет его суть.
Сколько переменных брать
Слишком мало — и сегменты получаются тривиальными. Слишком много — и алгоритм теряется в шуме, а сегменты не удаётся интерпретировать. Рабочий диапазон — от восьми до двадцати переменных. Если исходных утверждений больше, их сначала сжимают с помощью факторного анализа и кластеризуют уже факторные оценки.
Основные алгоритмы
Иерархическая кластеризация
Алгоритм последовательно объединяет самых похожих респондентов, затем похожие группы, пока все не окажутся в одном кластере. Результат изображается в виде дерева, на котором видно, на каком шаге объединение становится «дорогим». Метод нагляден, но плохо работает на больших выборках и чувствителен к выбросам.
Метод k-средних
Аналитик задаёт число кластеров, алгоритм распределяет респондентов так, чтобы каждый оказался ближе всего к центру своей группы. Это самый распространённый метод в маркетинге: быстрый, работает с тысячами анкет. Слабые места — нужно заранее знать число кластеров и результат зависит от стартовой точки.
Модельные подходы
Более современные методы — например, латентный классовый анализ — работают с переменными разных типов и дают для каждого респондента вероятность принадлежности к сегменту. Это удобно, когда часть данных категориальная: используемые бренды, каналы покупки.
На практике часто комбинируют подходы: иерархическая кластеризация на подвыборке подсказывает разумное число групп, а затем k-средних или модельный метод даёт окончательное разбиение на всей выборке.
Сколько сегментов нужно
Это вопрос, на который статистика даёт только подсказку. Формальные индексы качества кластеризации показывают, при каком числе групп разбиение наиболее чёткое. Но окончательное решение принимается по совокупности критериев:
- Различимость. Сегменты отличаются друг от друга по ключевым признакам, а не только по мелочам.
- Размер. Каждый сегмент достаточно велик, чтобы с ним стоило работать отдельно, — обычно не меньше пяти-семи процентов выборки.
- Интерпретируемость. Каждому сегменту можно дать понятное название и описать его одним абзацем.
- Применимость. Бизнес способен по-разному работать с этими сегментами — разными продуктами, сообщениями, каналами.
Часто сравнивают решения на четыре, пять и шесть кластеров и выбирают то, которое лучше всего удовлетворяет всем критериям сразу. Сегментация на двенадцать групп может быть статистически безупречной, но ни один отдел маркетинга не сможет с ней работать.
Проверка устойчивости
Красивое разбиение может оказаться случайностью конкретной выборки. Перед тем как представлять результаты, стоит убедиться, что сегменты воспроизводятся.
- Повторный расчёт на частях выборки. Выборку случайно делят на две половины и кластеризуют каждую. Если структура сегментов похожа, решение устойчиво.
- Разные стартовые точки. Для k-средних расчёт повторяют многократно с разными начальными центрами и проверяют, совпадают ли результаты.
- Проверка на внешних переменных. Сегменты должны различаться не только по переменным, на которых они построены, но и по поведению: покупкам, брендам, тратам. Если таких различий нет, сегментация бесполезна для бизнеса.
- Классифицирующее правило. Строится короткий набор вопросов, по которым нового респондента можно отнести к сегменту. Если точность правила высока, сегментацию можно использовать в будущих опросах и в CRM.
От кластеров к портретам
Итог статистической работы — таблица средних значений по каждому кластеру. Чтобы она стала полезной, её нужно превратить в портреты. Условный пример для рынка фитнес-услуг:
«Результатники»
Ставят конкретные цели, ценят тренеров и программы, готовы платить больше за персональное сопровождение. Чувствительны к качеству оборудования.
«Ищущие компанию»
Ходят в клуб ради атмосферы и групповых занятий, важны расписание и сообщество. Цена вторична, но уходят, если меняется любимый инструктор.
«Экономные практики»
Занимаются самостоятельно, нужен доступный зал рядом с домом без лишних услуг. Внимательно сравнивают цены абонементов.
Хороший портрет включает размер сегмента, его ключевые потребности, отличия от других групп, демографический профиль, поведение в категории и рекомендации, как с ним работать. Названия сегментов стоит делать живыми и запоминающимися, но не оценочными — «ленивые» или «нищие» плохо приживаются в компании.
Портреты полезно «оживить» качественным этапом: провести несколько глубинных интервью с представителями каждого сегмента. Цитаты и бытовые детали делают сегменты понятными для команды гораздо лучше, чем таблица средних. Подробнее об этом формате — на странице глубинных интервью.
Как внедрить сегментацию в работу компании
Самый уязвимый момент проекта — не расчёт, а передача результатов. Сегментация, которую обсудили на одной встрече и забыли, не окупает затрат. Чтобы она прижилась, полезно с самого начала вовлекать будущих пользователей: продуктовую команду, маркетинг, продажи. Их вопросы помогают выбрать переменные, а участие в обсуждении вариантов — принять итоговое решение как своё.
После утверждения сегментов стоит подготовить несколько рабочих материалов: краткую памятку с портретами для сотрудников, классифицирующую анкету для будущих опросов, правило разметки клиентской базы, если для этого хватает данных. Хорошим признаком внедрения служит момент, когда названия сегментов начинают звучать на планёрках без ссылки на отчёт.
Наконец, сегменты не вечны. Рынок меняется, появляются новые сценарии потребления, и раз в несколько лет структуру стоит проверять заново — хотя бы на уровне размеров сегментов и ключевых различий между ними.
Типичные ошибки
- Включение в кластеризацию всех переменных анкеты подряд, без связи с задачей.
- Смешивание переменных в разных шкалах без стандартизации: признак с большим разбросом начинает доминировать.
- Выбор числа сегментов только по формальному индексу, без оценки применимости.
- Отсутствие проверки устойчивости — сегменты «рассыпаются» при следующем замере.
- Сегментация, которую невозможно найти в реальности: нет признаков, по которым менеджер или система поймёт, к какому сегменту относится клиент.
Практические выводы
Кластерный анализ — это не кнопка в статистической программе, а последовательность решений, каждое из которых влияет на результат. Чтобы сегментация заработала, придерживайтесь нескольких принципов:
- начинайте с задачи бизнеса и подбирайте под неё переменные кластеризации;
- сжимайте большие батареи утверждений перед кластеризацией;
- сравнивайте несколько вариантов числа сегментов и выбирайте по применимости;
- проверяйте устойчивость и различия по поведению;
- превращайте кластеры в живые портреты и давайте инструмент для отнесения новых клиентов к сегментам.
Сегментация, построенная таким образом, становится общим языком для маркетинга, продаж и продуктовой команды — и служит компании не один год, а не только до следующей презентации.
Нужна помощь с исследованием? Специалисты NRay проведут исследование под вашу задачу — от постановки целей до презентации результатов. Оставьте заявку или напишите на [email protected].
Похожие статьи
Прогнозирование спроса на основе исследований: от намерений к объёмам продаж
Сказать «куплю» в анкете легко, а купить на деле — нет. Разбираем, как исследователи превращают заявленные намерения в реалистичный прогноз спроса и где чаще всего ошибаются.
Читать →
Кросс-табуляция: базовый инструмент анализа опросов
Таблица сопряжённости — самый простой и самый недооценённый способ анализа анкет. Объясняем, как её построить, какие проценты выбрать и как не сделать неверных выводов.
Читать →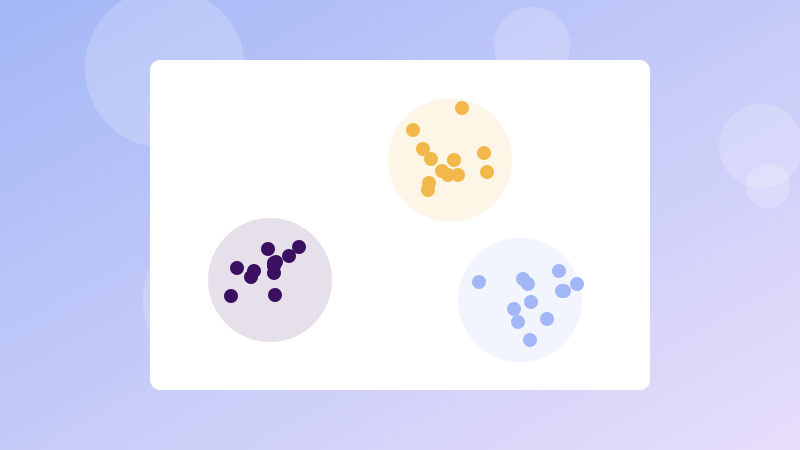
Кодирование открытых вопросов: как превратить свободные ответы в данные
Открытые вопросы дают самые живые ответы, но без грамотного кодирования они остаются набором цитат. Разбираем, как построить кодификатор и получить из свободных ответов надёжные цифры.
Читать →